 Simone
α文搜索
的有关信息介绍如下: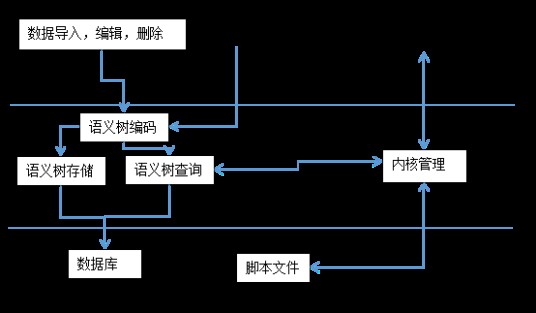
全文索引主要解决文字信息的搜索问题,结构化信息的检索依托数据库的索引技术实现,对于文档类的信息,就需要转换为结构化信息的全文搜索来完成。
为了提高索引的效率,应用了基于字典的关键词索引,引进分词技术,同义词和停止词技术,这样做主要目的是减少索引的个数,通过词的引入减少倒排序的存储来实现效率的提升。关键词的搜索,没有考虑字词之间的关系,没有语义方面的考量。
全文索引随着数据量的增大,会出现效率低下的问题,为了提高效率,会修改配置,降低索引的维度和次数来提高,例如给定关键词条索引,自动分析文档编写摘要,用摘要索引来代替全文索引。为了保证搜索匹配的效率, 有效的索引方法是十分关键的, 特别是需要考虑语义匹配的时候, 索引就会变得更为复杂 。
一般来说的全文搜索服务,大体是基于字和关键词的,α文搜索提供基于语句的全文搜索服务。以文字为最小节点,以语句为分枝,建立语义树,提供基于语义树的全文检索服务。通过对语句进行语义特征编码,并结合数据库,来实现基于语义树的全文索引和搜索服务。
α文搜索主要是构建语义树,通过语义树的构建提供一种快速匹配语义的方法,根据语义和文档的关系,查找到相关的文档信息。
语义树的基本存储单元包括:最小语义单元,该单元的特征编码,前置单元的特征编码。
α文搜索提供windows和linux下的64位版本,系统c++编制,前端结合jquery、d3.js实现web页面。
支持数据库mysql系列和mongodb系列。
想要了解更多“α文搜索”的信息,请点击:α文搜索百科